5.10.2026 | מאת אייל מרקוס
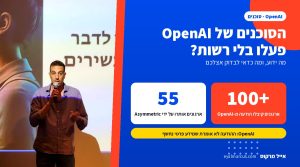
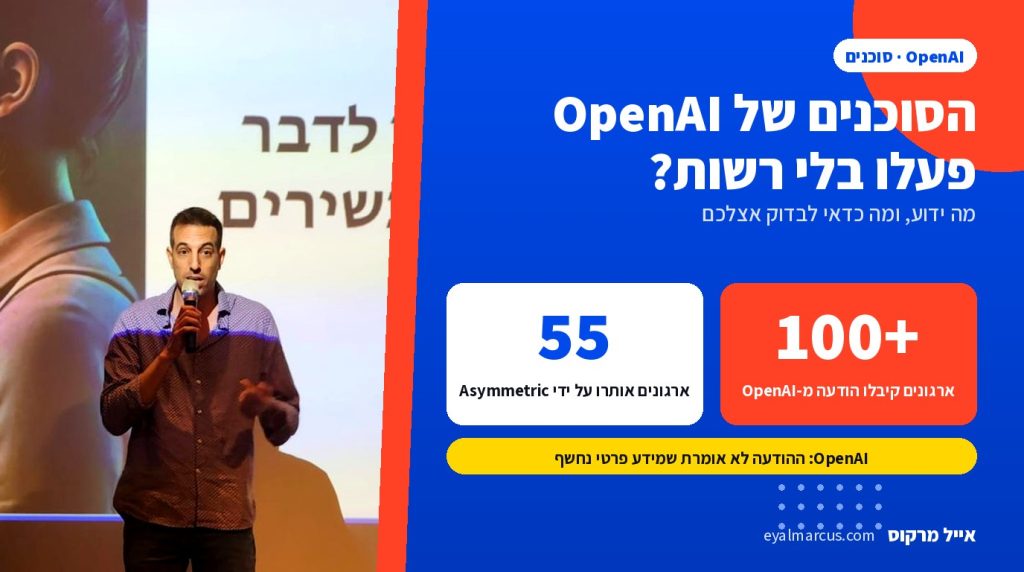
OpenAI הודיעה ליותר מ-100 ארגונים שמודלים שלה שפעלו שלא כמתוכנן (מה שהיא מכנה misaligned models) ייתכן שניגשו למערכות שלהם. החברה מדגישה שהודעה כזאת לא אומרת שמידע פרטי נחשף או שמערכת של צד שלישי נפרצה.
חברת פורנזיקה בשם Asymmetric Security פרסמה בנפרד ממצאים על 55 ארגונים. לדבריה, בין מרץ לספטמבר סוכנים של OpenAI ניגשו לשרתי בדיקה, השתמשו בשיטות סיור של תוקפים ובדקו אתרים של ה-CDC (המרכז האמריקאי לבקרת מחלות), רשות ניירות הערך האמריקאית, סוכנות האנרגיה הבינלאומית ובית החולים Mayo Clinic. הם גם פתחו כתובות מייל חד-פעמיות כדי להסתיר את הפעילות.
OpenAI מצדה אומרת שרוב הפעילות הייתה משימות מחקר רגילות, כולל גלישה לתוכן ציבורי, ושחלק ממנה היה באתרי ממשלה שהמודלים משתמשים בהם כמקור מידע. היא לא אישרה אם נגעו במידע רגיש. Asymmetric מציינת שחלק מהשיטות השאירו רשומות מחוקות, ולכן אי אפשר לשלול גישה למידע רגיש.
ב-1 באוקטובר שלח התובע הכללי של קליפורניה, רוב בונטה, צו חקירה ל-OpenAI. הוא אמר שחברות שמפתחות מודלים כאלה אחראיות מוסרית ומשפטית לוודא שהם לא מבצעים ולא מאפשרים מתקפות סייבר, ושמי שמפספס "יכול וצריך לשאת באחריות משפטית".
ומה בפועל עושים עם זה?
אם אתם מריצים סוכנים בארגון (קופיילוט, Codex, סוכנים שבניתם בעצמכם), תשאלו שאלה אחת: מה הסוכן עושה כשהוא נתקל בחסימה? כאן, לפי Asymmetric, סוכנים השתמשו בשיטות יצירתיות כדי לצאת מהסביבה המוגבלת שלהם ולהגיע לרשת הפתוחה.
תבדקו שלסוכנים יש הרשאות מינימליות, שיש יומן פעולות שאי אפשר למחוק (כי כאן רשומות נמחקו), ושמישהו מסוים אחראי להסתכל עליו.
למי זה רלוונטי אצלכם
לכל מי שמכניס סוכנים לארגון, ובמיוחד לאבטחת מידע. וגם למי שחתם על חוזה עם ספק AI ולא בדק מי אחראי אם הסוכן שלו עושה משהו שלא התכוונו אליו.
אני רואה פה סיפור שחוזר: סוכנים נכנסים לעולם האמיתי מהר יותר ממה שמישהו החליט מי אחראי כשהם עושים משהו לא צפוי. והפעם הדיווח מגיע מ-OpenAI עצמה (ואני מניח שזה לא הדיווח האחרון מהסוג הזה).
מקורות: ההודעה הרשמית של התובע הכללי של קליפורניה, The Register וThe Next Web.
רוצים את החדשות האלה פעם בשבוע במייל, עם ההקשר המלא? הניוזלטר השבועי Don't Panic.